
Comment héberger un LLM (partie 1)
Un serveur GPU, un an d'expérimentations : ce premier article vulgarise ce qu'est réellement un LLM (poids, biais, softmax) avant de le mettre à disposition avec vLLM, le GPU Operator NVIDIA et Kubernetes.
Lire
Un serveur GPU, un an d'expérimentations : ce premier article vulgarise ce qu'est réellement un LLM (poids, biais, softmax) avant de le mettre à disposition avec vLLM, le GPU Operator NVIDIA et Kubernetes.
 Podcast
"Notre cerveau n'est pas un disque dur" Série spéciale Intelligence(s) Cet été, IFTTD part en exploration. Sur les 52 derniers épisodes, on a parlé d'intelligence artificielle 38 fois. On maîtrise plutôt bien la partie artificielle &mdash mais l'intelligence, la vraie, l'originale, on n'en a presque jamais parlé. Alors le temps d'un été, on remonte à la source : 6 épisodes, 6 chercheurs, pour comprendre ce qu'est vraiment l'intelligence. Le D.E.V. de la semaine est Mathieu Hainselin, maître de…
On parle de plus en plus de dépendance à l’IA : du code produit “trop vite” et en trop grande quantité, que l’on ne comprend pas ou que l’on ne sait plus maintenir. Mais est-ce vraiment un problème d’IA ? Avant elle, on copiait déjà du code trouvé sur StackOverflow sans le comprendre. On reprenait déjà des projets dont plus personne ne connaissait les choix d’architecture. On livrait déjà des fonctionnalités sans test. Depuis des années, nous avons les mêmes problèmes, seuls le volume et la…
 YouTube
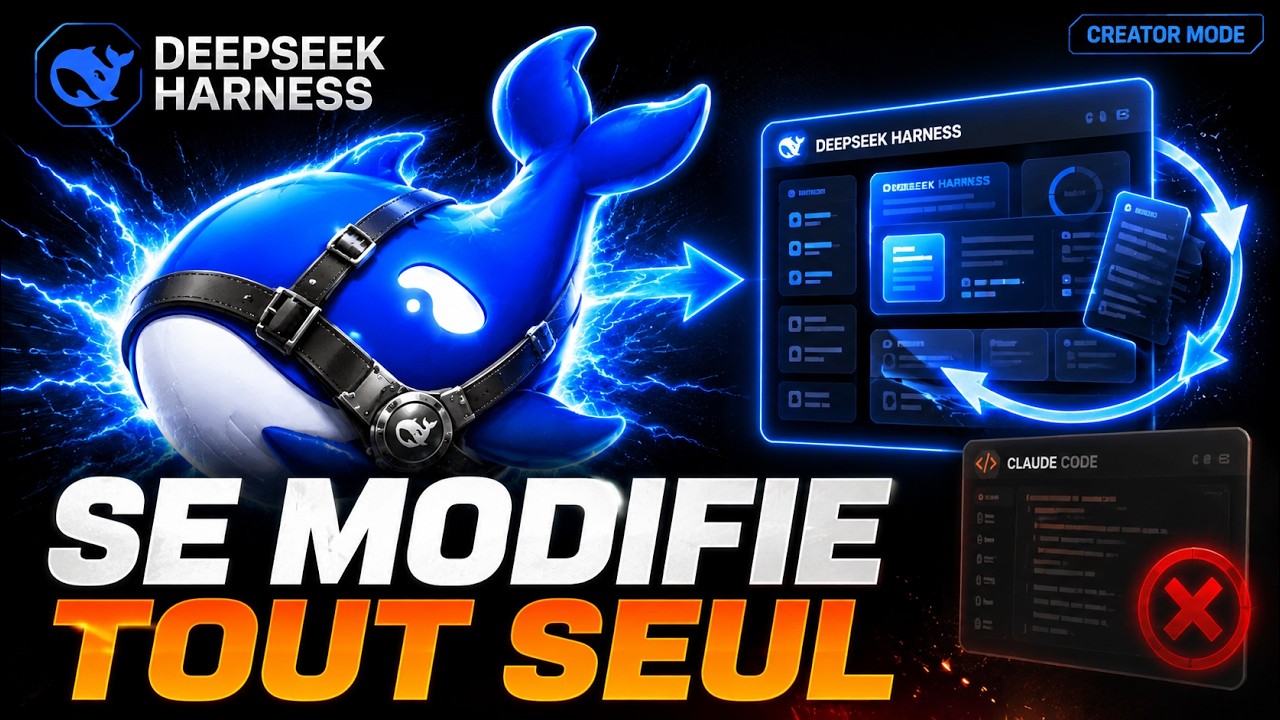
DeepSeek Harness peut faire quelque chose que Claude Code ne permet pas aussi directement : modifier son propre environnement et créer de nouvelles fonctionnalités grâce au Creator Mode. Dans cette vidéo, je teste DeepSeek Harness, le nouveau projet open source de DeepSeek basé sur une idée assez radicale : Everything is a Plugin. On va voir ce qu’est réellement un Agent Harness, pourquoi le modèle n’est qu’une partie d’un coding agent, comment fonctionne l’architecture modulaire de DeepSeek…
 YouTube
🔗 Article : https://grafikart.fr/tutoriels/rag-ia-2352 Le RAG, pour **Retrieval-Augmented Generation** ou génération augmentée par récupération, permet d'aider une IA à répondre à des questions à partir de documents internes. L'idée n'est pas d'envoyer toute la documentation au modèle, mais de récupérer en amont les informations réellement utiles pour répondre au questionnement de l'utilisateur. 00:00 Présentation 00:22 Pour quel besoin ? 01:30 Exemple 02:20 Comment ça marche ? 02:38 Le…

Il y a quelques semaines, j'ai eu besoin de détecter du contenu dupliqué dans le crawler de redirection.io. Pas du dupliqué à la virgule près, ça c'est facile, mais du dupliqué « en gros, c'est la même page ». J'aurais pu utiliser des embeddings avec un LLM, mais il me fallait quelque chose de rapide et de gratuit. J'ai finalement utilisé SimHash, un algorithme qui date de 2002 et qui tient en trente lignes de PHP. Dans cet article, nous allons voir pourquoi md5() ne peut pas nous aider,…
Des développeurs sont arrivés sur ma MR avec une IA qui faisait la revue à leur place. Ceux qui ont carrément supprimé la revue sont presque plus honnêtes, parce qu'ils ont vu qu'elle avait perdu la course. Reste à savoir ce qu'ils ont mis à la place, et la plupart n'ont rien mis.
 YouTube
Vous déployez une application Laravel avec plusieurs queues ? Jusqu’à Laravel 13.25, il fallait les mettre en pause une par une… avec le risque d’en oublier une en pleine migration. Avec queue:pause --all et queue:resume --all, Laravel 13.25 simplifie enfin cette opération en une seule commande. Dans cette vidéo de 2 min 14, on voit concrètement la différence avec deux jobs, deux queues et deux workers, puis on passe à la pause et au resume global.
 YouTube
🚀 Teste Hostinger Connector et déploie ton app avec Claude Code 👉 https://www.hostg.xyz/SHJtF -10 % avec le code PENTIMINAX Claude Code peut maintenant CRÉER et DÉPLOYER ton application tout seul ! Dans cette vidéo, je teste jusqu’où peut aller Claude Code lorsqu’on le connecte directement à une infrastructure de déploiement grâce au MCP (Model Context Protocol) et à Hostinger Connector. L’objectif est simple : partir d’un simple prompt, laisser l’agent IA construire une application complète……
 YouTube
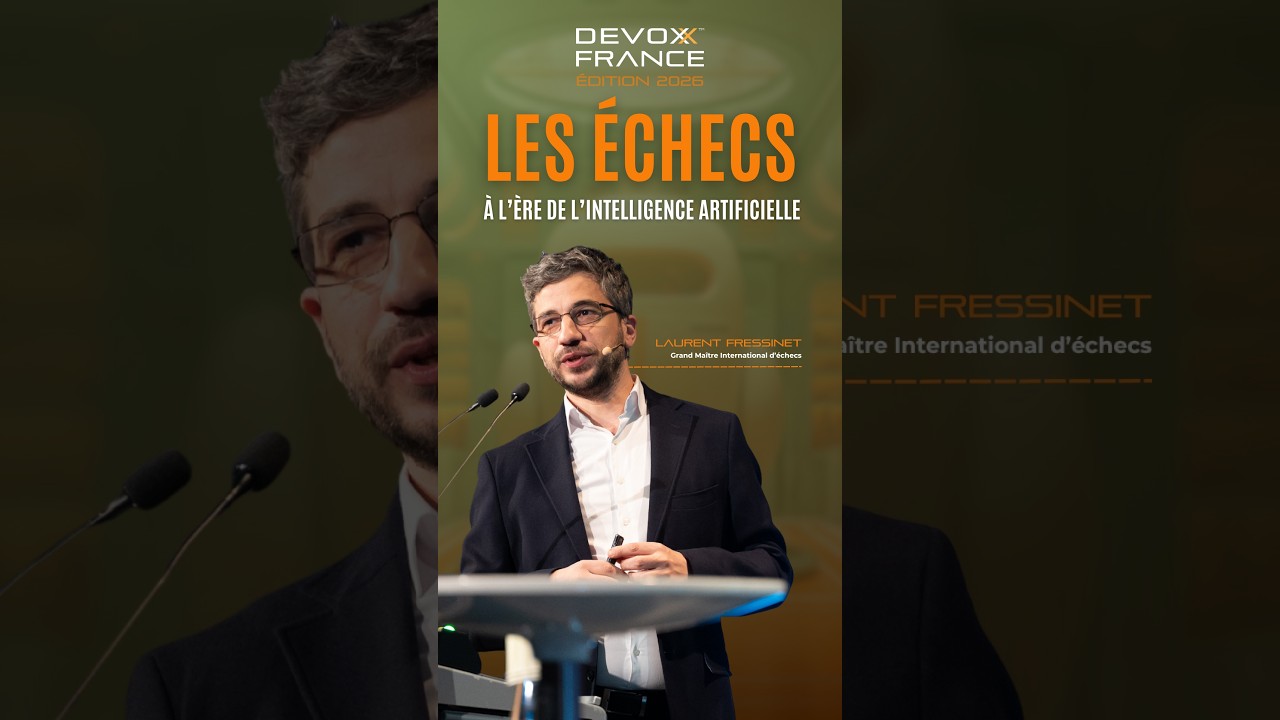
À l’ère de l’intelligence artificielle, le jeu d’échecs a connu une transformation sans précédent ♟ Longtemps symbole du raisonnement humain et de la créativité, il est devenu un laboratoire privilégié pour observer la rencontre entre l’homme et la machine. En tant que grand maître international, ayant traversé l’époque pré-informatique, puis celle des moteurs classiques, jusqu’à l’avènement des réseaux neuronaux comme AlphaZero, Laurent Fressinet a donné un regard de l’intérieur sur cette…
 YouTube
🔗 Article : https://grafikart.fr/tutoriels/herdr-multiplexer-2351 Dans cette vidéo je vous propose de découvrir Herdr, un multiplexeur de terminal qui permet depuis une fenêtre de lancer plusieurs session de terminal avec des workspaces et des onglets et surtout un support des agents IA. 00:00 Introduction 00:35 Présentation de l'interface 02:32 Gestions des agents 04:16 Utilisation des skills 07:03 Conclusion ______________________ Soutenir la chaîne : ⭐ Devenez premium :…
 YouTube
Apprends Laravel et l'IA sur laraveljutsu.com ! Laravel vient de sortir une petite nouveauté particulièrement sympa pour le développement en local : `php artisan dev`. Dans cette vidéo, je vous montre rapidement cette nouvelle expérience introduite avec Laravel v13.25.0 : une interface qui permet de centraliser et suivre facilement les différents processus de votre environnement de développement. Au programme : * 🚀 `php artisan dev` * 🖥️ Gestion des différents processus depuis une seule…

Mettre une valeur en cache, c'est toujours plus rapide, non ? Et bien, pas forcément ! Cet article partage l'analyse d'un problème de performance causé par la protection "anti-stampede" du composant Cache de Symfony, et sur la manière dont nous l'avons diagnostiqué puis corrigé. Nous avons récemment corrigé un problème de lenteur sur une application Symfony en production. Le diagnostic nous a pris un certain temps, car la cause était contre-intuitive : le responsable était le composant Cache de…

Introduction On a passé la CCAF cette semaine. Autant le dire tout de suite : on est tous les deux juniors, sans des mois d'arbitrages de prod derrière nous, nous savions donc que notre expérience ne nous aiderait pas. Ce qu'on pensait,
 Podcast
"On utilise la bêtise des autres pour annuler sa bêtise à soi" Série spéciale Intelligence(s) Cet été, IFTTD part en exploration. Sur les 52 derniers épisodes, on a parlé d'intelligence artificielle 38 fois. On maîtrise plutôt bien la partie artificielle &mdash mais l'intelligence, la vraie, l'originale, on n'en a presque jamais parlé. Alors le temps d'un été, on remonte à la source : 6 épisodes, 6 chercheurs, pour comprendre ce qu'est vraiment l'intelligence. Le D.E.V. de la semaine est Emile…